一人公司如何建立 AI Native 流程,我的 5 点建议
 Peter主理人 · · 阅读
最近一段时间,我把整套 Affiliate 投放搬到 AI Native 流程上。
带来的结果是:每天盯广告的时间从4小时压到1小时。剩下的时间我在想下一个项目做什么。
这套流程怎么搭,今天分享5点建议。
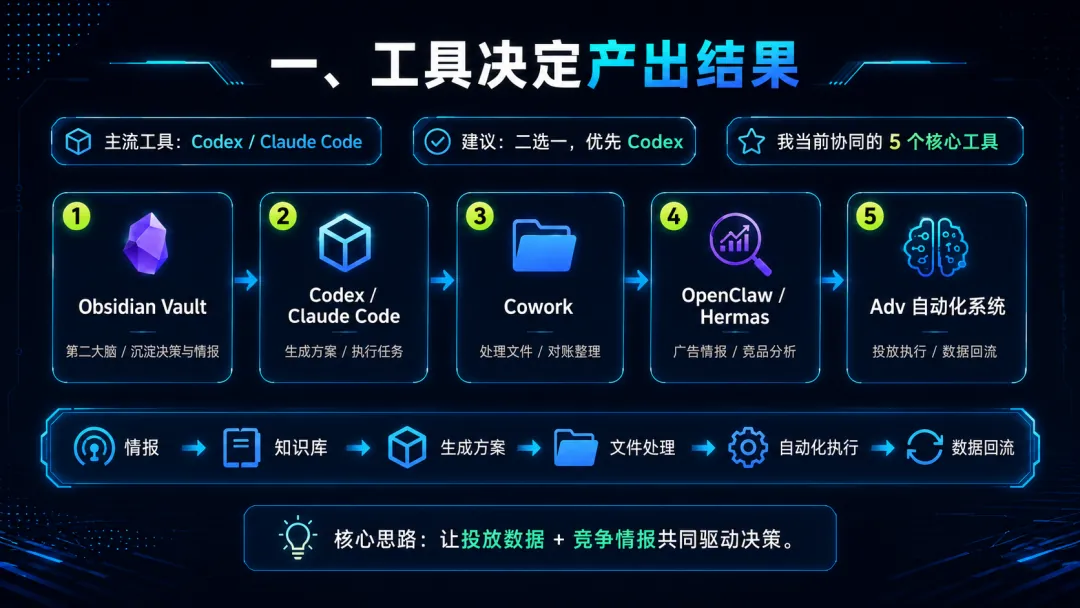
一、工具决定产出结果
主流就两个,Codex 和 Claude Code。
建议二选一。如果你不想折腾账号、想要稳定,优选Codex。如果你能搞定,Claude Code也不错。我个人更喜欢 Claude Code。
我目前协同的工具里有5个核心:
Obsidian Vault:第二大脑。所有决策、复盘、画像、投放记录、情报全沉淀进去。
Codex:处理稳定性要求高的脚本和编码任务。
Claude Code:写新的Agent、做实验性Flow。
Cowork:处理文件类工作。我之前那篇《Claude Cowork:我的第一个数字员工》讲过怎么帮我对账。
OpenClaw/Hermas:抓广告情报+竞品分析,情报同步Obsidian,再回流 Adv Agent。
工具不是越多越好,关键是它们能不能联动。
比如:Hermas抓到的竞品广告→同步到Obsidian→Obsidian又跟关联Adv Agent关联。
这样我做决策时,数据源不只来自我的投放,还包含自竞争对手的最新动作。
二、 Skills 定义你的 Flow
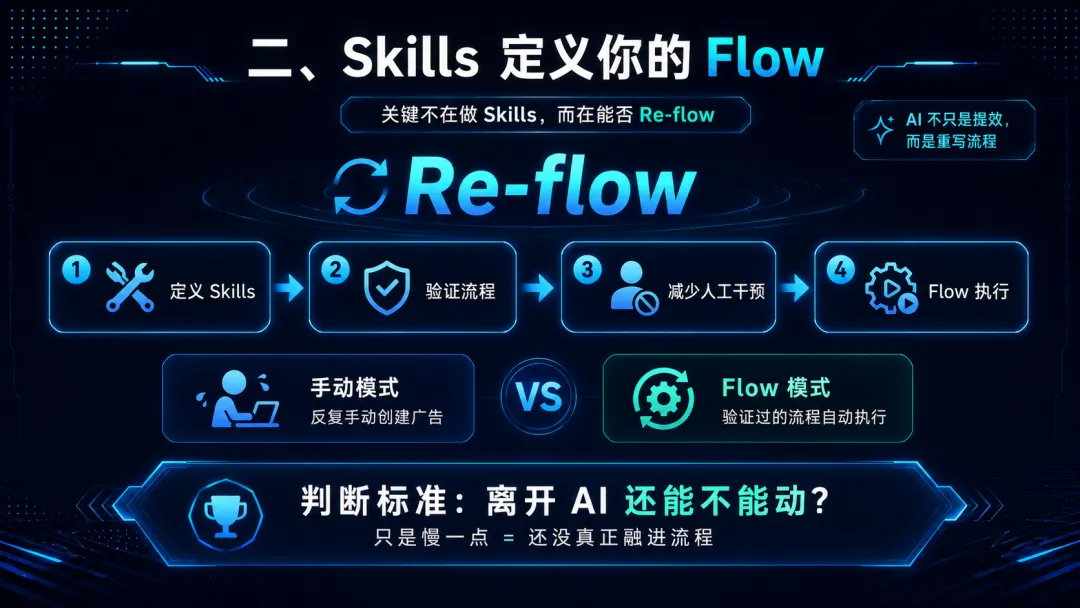
借助大模型写 Skills 已经很容易,但一个 Skills 对业务到底有没用,标准只有一个:Re-flow。
Re-flow 的意思是:把原来需要手动做的动作,下沉成可复用的流程。
举个例子:之前给Openclaw100美金跑广告,有人觉得还不如自己点两下快,AI还容易出错。
换个角度——它在帮我验证流程。一旦这个流程跑通,我后面所有同类操作不再需要手动介入。
相当于我跳出来,让验证过的 Flow 替我执行。这跟反复手动创建广告,是完全两件事。
一个 Skill 是不是真的融进流程,判断标准很简单:离开 AI 这条流程就跑不动了。
如果离开 AI 只是慢一点,说明 AI 还只是个加速器,没真正接管环节。
真正融进流程的 Skill 改变的是结构,不是速度。
三、用环境替代自律
以前带过几个朋友入行,都没坚持住。
这些年,我对靠自律推动这件事有不同看法。人对自己最仁慈也最容易破例。
今天就测到这里了、手动算一下就行——这种念头一出现,整套系统就难构建。
我的解法是让脚本和协议替我强制做这件事。
两个具体例子。
例子一:我的 Claude Code 会话开头有段协议,自动跑一个audit脚本告诉我,有多少篇文章发布了,但没做对比学习。
我不主动想这件事,脚本主动告诉我,这件事就不会断。
例子二:我写完一篇文章把链接给 AI,它自动走完:抓取发布版 → 跟草稿 diff → 提取我修改过的句子和原因 → 写进 Obsidian。
整个流程不需要我主动触发。
四、AI干活之前,先定义什么算好
用AI做事之前,先回答一个问题:什么是好的标准?
举我自己的例子:我现在创建广告投放前,必须先读三个 Vault 页面——广告偏好、历史数据、情报收集。没读这些,就列广告草稿 = 违规。
为什么?AI 知道的东西很多,但它不知道我是谁、我擅长投什么 GEO、什么 vertical、我之前哪些 campaign 跑赢过。
所以我让 AI 做了一件事——反向蒸馏我的投放数据。
反向蒸馏的意思是:从我历史所有的 winner 和 loser 里,反向提炼出我的偏好和打法规律。
如果直接让 AI分析跑赢的 campaign,它会列一堆毫无关联的特征。
所以我先帮它定义什么算共性 pattern——必须能溯源到具体 campaign、必须有具体引用、必须区分独有特征 vs 共有规则。
先定义什么是好,再让 AI 干活。这一步省了,后面所有 AI 输出都是无效内容。
五、5层结构+判断力是稀缺资源
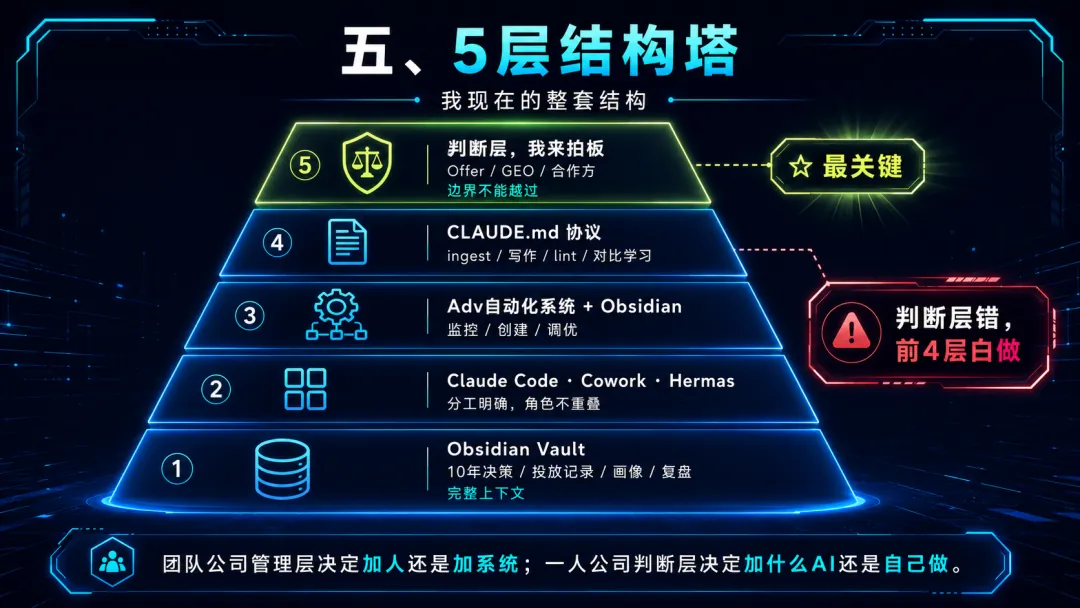
我现在的整套结构是5层:
第一层 数据层:Obsidian Vault。
10年所有决策、投放记录、读者画像、失败复盘沉淀进去。AI跟我协作时能读到完整上下文,不用每次从零开始。
第二层 工具层:
Claude Code写代码、Cowork处理文件、Hermas抓情报,每个工具角色明确不重叠。
第三层 流程层:
Adv广告自动化系统+Obsidian知识库体系跑在后台。监控、创建、调优自动跑,我做关键决策。
第四层 Skill层:
CLAUDE.md协议规定所有workflow——怎么ingest内容、怎么写文章、怎么lint、怎么对比学习。
第五层 判断层:
决定哪些事AI做、哪些事我做、边界绝不让AI越过。
前 4 层做得再好,第 5 层错了,这套系统就废。
而判断层为什么是稀缺资源?因为它不能被外包,也不能被蒸馏。
我现在同时跑 3 个项目——Constructor Page 套利、Adv Agent 构建、Obsidian 知识库联动。
看似不相关,当我把它们联动起来,就是 10 倍杠杆。
这个联动起来的能力,就是判断力的具体表现。它来自三件事:
经验:自己跑过、踩过的坑。我花几万美金测出来的广告定向,可以稳定跑 1-2 个月,AI 替不了——它没替我亏过那些钱。
数据:行业的真实数据。除了蒸馏自己,还要蒸馏别人,建立自己的判断坐标系。AI 能聚合,但拍板的还是我。
思考时间:不被打断的连续思考。过去每天 3-4 小时盯账户、整理报表、对账。现在自动化把这些时间还给我了,思考时间从每天 1 小时变成 3 小时。
写在最后
这套架构给我腾出不少时间,让我在跑广告之余还能做点别的事。
如果要挑一个我最喜欢的特性,我会选自学习。
自学习的意思是:当数据层、工具层、流程层、Skill 层都闭环之后,系统会自己优化自己。
-
投放数据回流进 Obsidian
-
Obsidian 里新增的 pattern 自动更新到 Adv Agent 的判断逻辑
-
Hermas 抓到的竞品动作变成新的测试任务
-
测试结果再回流进数据层
我不主动推它,它也能自己往前滚。
这才是 AI Native 的终点:不是 AI 替我干活,是这套流程替我成长。
Peter的Affiliate之路